1. はじめに
Nintendo 64 のハードの仕組みを調べ始めたら面白かったので、Kamo64というNintendo64エミュレータを自作してみました。
この記事では、まずエミュレータとは何か、Nintendo 64 のハード構成をざっと説明したうえで、Kamo64 でどう実装したかについて説明しようと思います。
1.1 エミュレータの仕組み
エミュレータは、ハードウェアの動作をソフトウェアで再現するためのプログラムです。身近な例だと、いろいろな CPU を動かす QEMU や、Android を動かす BlueStacks、ゲーム機なら(当時話題だった)Switch エミュレータの yuzu などがあります。
ごく単純化すると、CPU エミュレーションの芯は命令を取る(fetch)、命令を解釈する(decode)、命令を実行する(execute)の繰り返しです。このループをC++で表現すると、以下のようなコードになります:
uint32_t pc;
uint64_t gpr[32];
uint8_t  mem[MEM_SIZE];

void step() {
    // 1. Fetch: プログラムカウンタが指す機械語を読む
    uint32_t inst = load32(mem, pc);
    pc += 4;

    // 2. Decode: 命令の種類とそのオペランドの解釈
    uint32_t op = inst >> 26;
    uint32_t rs = (inst >> 21) & 31;
    uint32_t rt = (inst >> 16) & 31;
    uint32_t imm = inst & 0xffff;

    // 3. Execute: レジスタやメモリを書き換える
    // 例: 加算命令 addiu rt, rs, imm
    if (op == 0b001001) {
        gpr[rt] = gpr[rs] + (int16_t)imm;
    }
    // ... あとは命令の種類だけ分岐が増える
}
最近のコンピュータは PCIe や GPU、複雑な周辺まで載せているので、ちゃんと作ろうとすると大変です。Nintendo 64 には PCIe も現代的な汎用 GPU もありませんが、3D のための専用プロセッサ(RDP)に加えて、もう一つの CPU(RSP)が載っています。つまり単一のプロセッサのエミュレーションに加えて、複数のユニットが共有メモリ越しに協調する仕組みを再現する必要があります。
1.2 HLE と LLE
ゲーム機エミュレータの話になると、よく HLE と LLE という言葉が出てきます。
HLE(High-Level Emulation)はゲームが動くために必要な振る舞いを、できるだけ高い抽象度で再現する方針です。OS の API やグラフィックスの結果をホスト側の実装に置き換えるイメージです。現代の高性能エミュでは、速度のために HLE がよく使われますが、後述の LLE と比べて、エミュレーションの正確性が低いです。
一方で、LLE(Low-Level Emulation)はレジスタやバス、DMA、割り込みといった、よりハードウェア寄りの層までソフトウェアで実装する方針です。遅く、実装が大変になりやすい反面、エミュレーションの正確性が高いというトレードオフがあります。
1.3 今回作ったもの: Kamo64
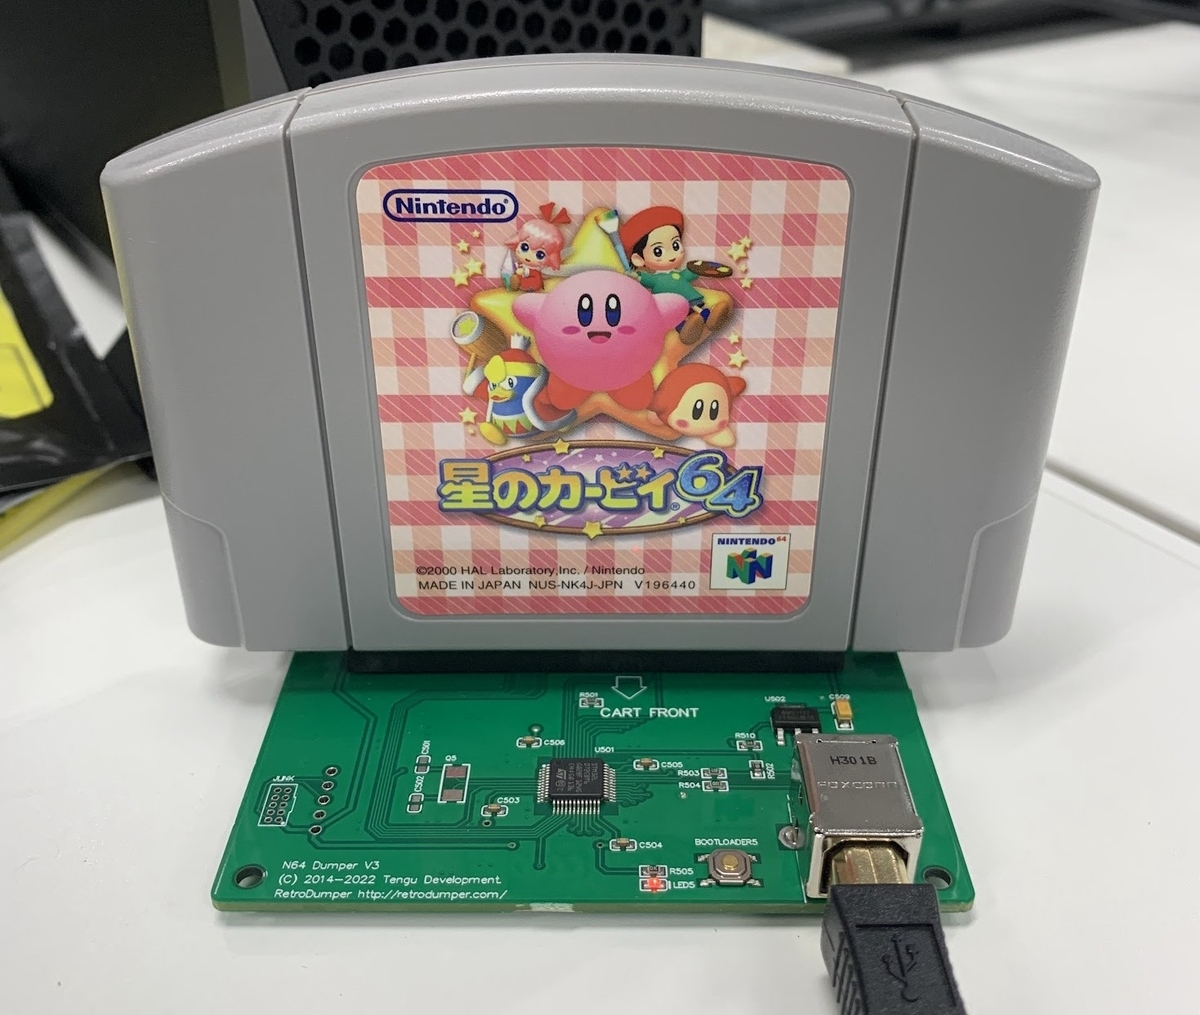
C++ で LLE 方式のNintendo64エミュレータとして Kamo64 を開発しました。 グラフィック、音声、コントローラなどゲームをプレイするために必要な機能は大体実装されています。 市販のROMとしてカービィ64で動作確認をしました。
👇️実際の起動の様子
ROMをファイルとして抽出するには専用の機械が必要になります。
2. Nintendo 64 のアーキテクチャ
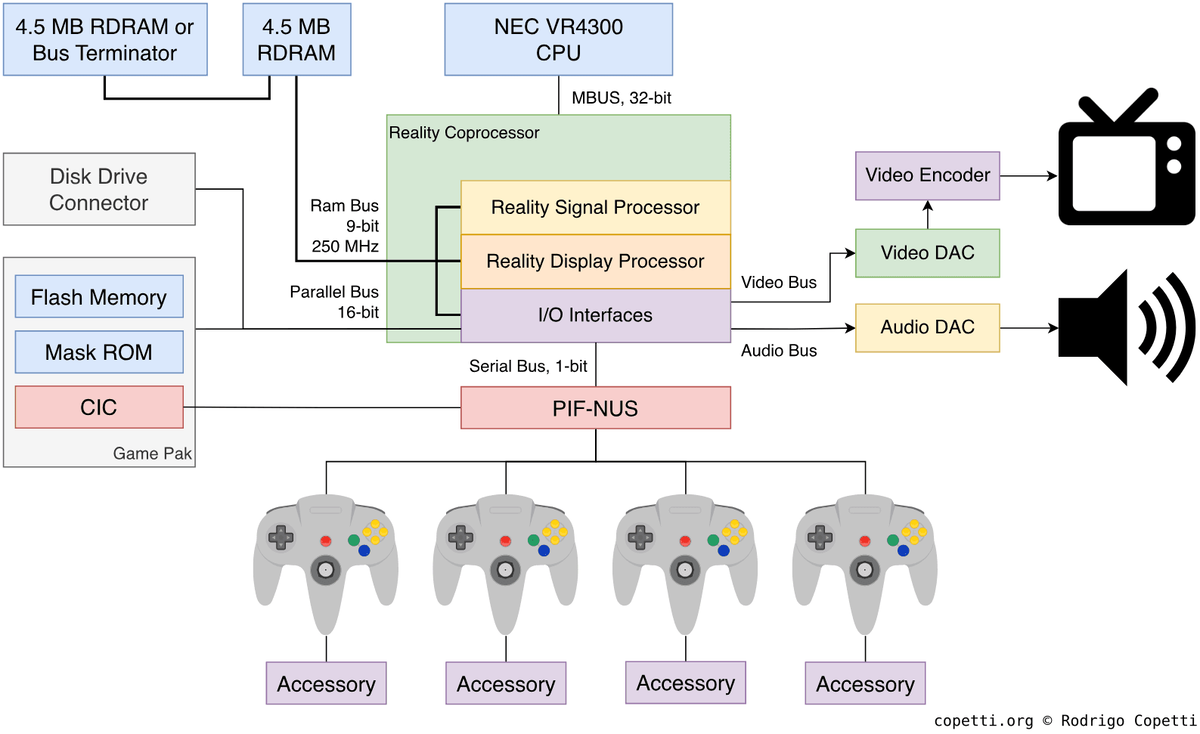
図は Rodrigo Copetti, Nintendo 64 Architecture より引用。
Nintendo 64 は大きく分けて次のコンポーネントが動作しています。
- メイン CPU: NEC VR4300(MIPS R4300i)、93.75 MHz、FPUあり
- RCP(Reality Co-Processor): コプロセッサ、62.5 MHz
- RDRAM: 共有メモリ。CPU や RCP はこれを経由してデータをやり取りする
- カートリッジ / PIF など周辺
Nintendo64のメイン CPU には SIMD 命令がなく、また現代の GPU のアーキテクチャが確立されていませんでした。 そのため、グラフィックス処理に必要なベクトル演算は専用の RSP というコプロセッサで行いました。
CPU と RCP のクロックは同じではなく(93.75Mhz : 62.5Mhz = 3:2)。エミュレータではこのクロックの比を意識して時間を進める必要があります。
CPU からの MMIO 書き込みをきっかけに、各ユニットが動き、協調動作を実現しています。
2.1 RCP の中身
RCP の中はざっくり次のような役割分担です。
| 名前 | 役割 |
|---|---|
| RSP(Reality Signal Processor) | スカラー+ベクトルユニット。ジオメトリや音声処理などに使われる。 |
| RDP(Reality Display Processor) | ラスタライズ、テクスチャ、ブレンディング、Z バッファなどグラフィックパイプラインの後半で使われる。 |
| VI(Video Interface) | フレームバッファをテレビ信号に変換する。エミュレーションではテレビではなく、ホストの画面に表示すれば良い。 |
| AI(Audio Interface) | 波形データを DAC 変換する。これもホストで波形を再生すればよいだけ。 |
| PI(Peripheral Interface) | カートリッジ ROM などとの DMA に使われる。 |
| SI(Serial Interface) | コントローラ/PIF 方面 |
| MI(MIPS Interface) | 割り込みの集約など |
RSP はメイン CPU より遅いクロック側(RCP 全体が 62.5 MHz)で動きます。FPU は無く、ベクトル命令で 8 要素ぶんまとめて計算する、といった性格です。ゲームは Display List / Audio List を RAM に置き、RSP にマイクロコードとタスクを投げて動かします。
1 フレームのイメージはこうです。
- CPU がゲームロジックを回す
- RSP にジオメトリ等のタスクを投げる
- RDP が描画コマンドを処理し、フレームバッファを更新する
- VI が走査に合わせて画面を出す
- AI / SI が音声・入力を並行して扱う
エミュレータは、この協調動作ごと再現する必要があります。
3. エミュレータの実装
3.1 スケジューリング
エミュレータをどう駆動するかは最も難しく、重要な設計ポイントだと思います。
Kamo64 では、時間の基準を CPU サイクルにしています。おおよそ、画面の走査線を進めるたびにその分だけ CPU を走らせるようになっています。
前述のCPU と RCP の周波数比 3:2 ですが、毎回2つのクロックを交互に刻む方法は単純ですが遅いので、少し工夫をしています。RSP が消費したサイクルを 3/2 することで、CPU 時間に換算して、スケジューラのイベントとして待ち合わせることで、RSP と CPUのタイミングを同期しています。
周辺機器はCPUサイクルを基準としたイベントキューで動かしています。たとえば AI にオーディオの再生開始コマンドを書いた場合、それが何サイクル後に完了するという予定をタスクとしてイベントキューに入れておきます。あとで CPU が進んでその時刻になると、対応する割り込みなどを起こします。
3.2 CPU
メイン CPU は MIPS R4300i で MIPS 系の命令セットを利用します。おそらく、もっとも特徴的な点は Delay slot だと思います。(私はパタヘネでしか知りませんでした。)
Delay slot は分岐の直後の 1 命令は、分岐の成否に関係なく(branch-likely を除き)実行されるというものです。
ほかには、仮想アドレスと物理アドレスの変換を行う MMU や TLB がありますが、変換のキャッシュに使われる TLB すらエミュレーションするのにやや時間がかかるので、ホスト側でホットパスとしてキャッシュを持つことで速くしています。
3.3 RSP
RSP はメイン CPU とは別の CPU で、独自のベクトル拡張命令を実装しています。この命令セットは有志によって明らかになっています。
ベクトルユニットには、32本の128bitのレジスタがあり、各レジスタを8つの16bit値としてまとめて計算することができます。 Kamo64 では、一部の命令を Intel SSE でホストの SIMD 命令として実行することで高速化しています。
3.4 RDP
ラスタライズなどを行う RDP は、N64 界隈では Parallel-RDP という RDP エミュレーション専用のライブラリ がよく使われます。Vulkan による GPU レンダリングやアップスケーリングなどが実装されており、Kamo64 でも Parallel-RDP を採用しました。
Parallel-RDP を使わずに、いつかはレンダリングも自前で実装してみたいなと思っています。
3.5 ブートプロセス
実機のブートシーケンスは以下の流れで行われます。
- PIF-NUS がカートリッジの CIC を検証する
- CPU が PIF 内 ROM(IPL1)から実行を始める
- IPL2 → IPL3 と続き、RDRAM やキャッシュを初期化し、ゲームコードへ飛ぶ
CIC とはカートリッジに入っている海賊版対策用のチップで、6102、6102などのいくつかの型番が存在します。 CIC は PIF-NUS というゲーム機本体のチップによって検証され、その後の IPL の実行コードはゲーム機本体(PIF-ROM)が持っています。
ブートプロセスをエミュレーションでは、これらのステップを厳密に行わない、すなわち、CIC 種別を ROM の先頭付近のチェックサムから推定し、IPL3 実行後のレジスタやメモリの状態をでっち上げることで実現しています(HLE に近い)。
ブーロプロセスはこれらの記事がより詳しいです。
3.6 OS
N64 には本体に載った大きな BIOS や OS はありません。代わりに、カートリッジ側の ROM に、小さなカーネル相当のコードが入っています(ライブラリ OS の概念に近いと言えます)。これらのカーネル相当のライブラリには、マルチスレッドやメッセージ、スケジューリングの薄い抽象レイヤが入っています。
したがって、LLE では、BIOS や OS のエミュレーションは必要ありませんが、RSP 周りのレジスタやメモリから、音声やグラフィックスのタスクに対応するデータ(OSTaskと呼ばれる)を観察することができます。
3.7 コントローラ
実機では、入力はだいたい次の流れです。
- コントローラのボタン/スティック状態を読む
- ゲームが SI 経由で、RDRAM と PIF RAM のあいだでコマンド/応答を転送する
- PIF がそのコマンドを解釈し、接続確認やボタン/スティックの値を応答として返す
エミュレータでは、1 をホスト側のキーボードやゲームパッド入力に置き換え、64コン相当の状態として保持します。ゲームが問い合わせてきたときに PIF がその状態を応答に載せるので、2・3 のプロトコルはそのまま再現すればよいです。ここでは PIF も、命令レベルでエミュレーションせずに、PIF 専用コマンドを HLE でエミュレーションしています。
3.8 高速化
多くの N64 ソフトは実質 30 fps 前後で、映像出力はインターレース(奇数/偶数線を約 16.7 ms ごとに更新する方式)で動作します。したがって、エミュレーションの高速化はこの 16.67ms の枠に対して間に合うためのボトルネックを潰す作業になります。
当初はメイン CPU の JIT を頑張って実装していました。ところが、
- cached interpreter を速くする
- RSP の SIMD
あたりを詰めると、JIT が無くても処理落ちせずに動作できそうなことが判明しました。
cached interpreter はインタプリタ実行において、命令を毎回デコードし直さず、デコード結果をキャッシュしておく方式です。各機械語を実行する関数のポインタとして用意しておいて、その関数ポインタの配列としてページごとにデコード結果をキャッシュすればよいです。
JIT は依然として有用ですが、開発や保守のコストを考えると、インタプリタに絞るのが良いと思います。もしかしたら、GBA、DS、3DS のエミュレータでも同様のことが言えるかもしれません。
4. おわりに
エミュレータ開発は大変ですがとても楽しいです。 近年は AI も実装やデバッグにかなり使えるようになってきていて、以前より苦しさは減ってきていると思います。
Kamo64 はコントリビューションも大歓迎です!
謝辞
開発に協力してくれた以下の方々ありがとうございました。
