Nintendo 64 エミュレータを自作した

1. はじめに

Nintendo 64 のハードの仕組みを調べ始めたら面白かったので、Kamo64というNintendo64エミュレータを自作してみました。

github.com

この記事では、まずエミュレータとは何か、Nintendo 64 のハード構成をざっと説明したうえで、Kamo64 でどう実装したかについて説明しようと思います。

1.1 エミュレータの仕組み

エミュレータは、ハードウェアの動作をソフトウェアで再現するためのプログラムです。身近な例だと、いろいろな CPU を動かす QEMU や、Android を動かす BlueStacks、ゲーム機なら(当時話題だった)Switch エミュレータの yuzu などがあります。

ごく単純化すると、CPU エミュレーションの芯は命令を取る(fetch)、命令を解釈する(decode)、命令を実行する(execute)の繰り返しです。このループをC++で表現すると、以下のようなコードになります:

uint32_t pc;
uint64_t gpr[32];
uint8_t  mem[MEM_SIZE];

void step() {
    // 1. Fetch: プログラムカウンタが指す機械語を読む
    uint32_t inst = load32(mem, pc);
    pc += 4;

    // 2. Decode: 命令の種類とそのオペランドの解釈
    uint32_t op = inst >> 26;
    uint32_t rs = (inst >> 21) & 31;
    uint32_t rt = (inst >> 16) & 31;
    uint32_t imm = inst & 0xffff;

    // 3. Execute: レジスタやメモリを書き換える
    // 例: 加算命令 addiu rt, rs, imm
    if (op == 0b001001) {
        gpr[rt] = gpr[rs] + (int16_t)imm;
    }
    // ... あとは命令の種類だけ分岐が増える
}

最近のコンピュータは PCIe や GPU、複雑な周辺まで載せているので、ちゃんと作ろうとすると大変です。Nintendo 64 には PCIe も現代的な汎用 GPU もありませんが、3D のための専用プロセッサ(RDP)に加えて、もう一つの CPU(RSP)が載っています。つまり単一のプロセッサのエミュレーションに加えて、複数のユニットが共有メモリ越しに協調する仕組みを再現する必要があります。

1.2 HLE と LLE

ゲーム機エミュレータの話になると、よく HLE と LLE という言葉が出てきます。

HLE(High-Level Emulation)はゲームが動くために必要な振る舞いを、できるだけ高い抽象度で再現する方針です。OS の API やグラフィックスの結果をホスト側の実装に置き換えるイメージです。現代の高性能エミュでは、速度のために HLE がよく使われますが、後述の LLE と比べて、エミュレーションの正確性が低いです。

一方で、LLE(Low-Level Emulation)はレジスタやバス、DMA、割り込みといった、よりハードウェア寄りの層までソフトウェアで実装する方針です。遅く、実装が大変になりやすい反面、エミュレーションの正確性が高いというトレードオフがあります。

1.3 今回作ったもの: Kamo64

C++ で LLE 方式のNintendo64エミュレータとして Kamo64 を開発しました。 グラフィック、音声、コントローラなどゲームをプレイするために必要な機能は大体実装されています。 市販のROMとしてカービィ64で動作確認をしました。

👇️実際の起動の様子

ROMをファイルとして抽出するには専用の機械が必要になります。
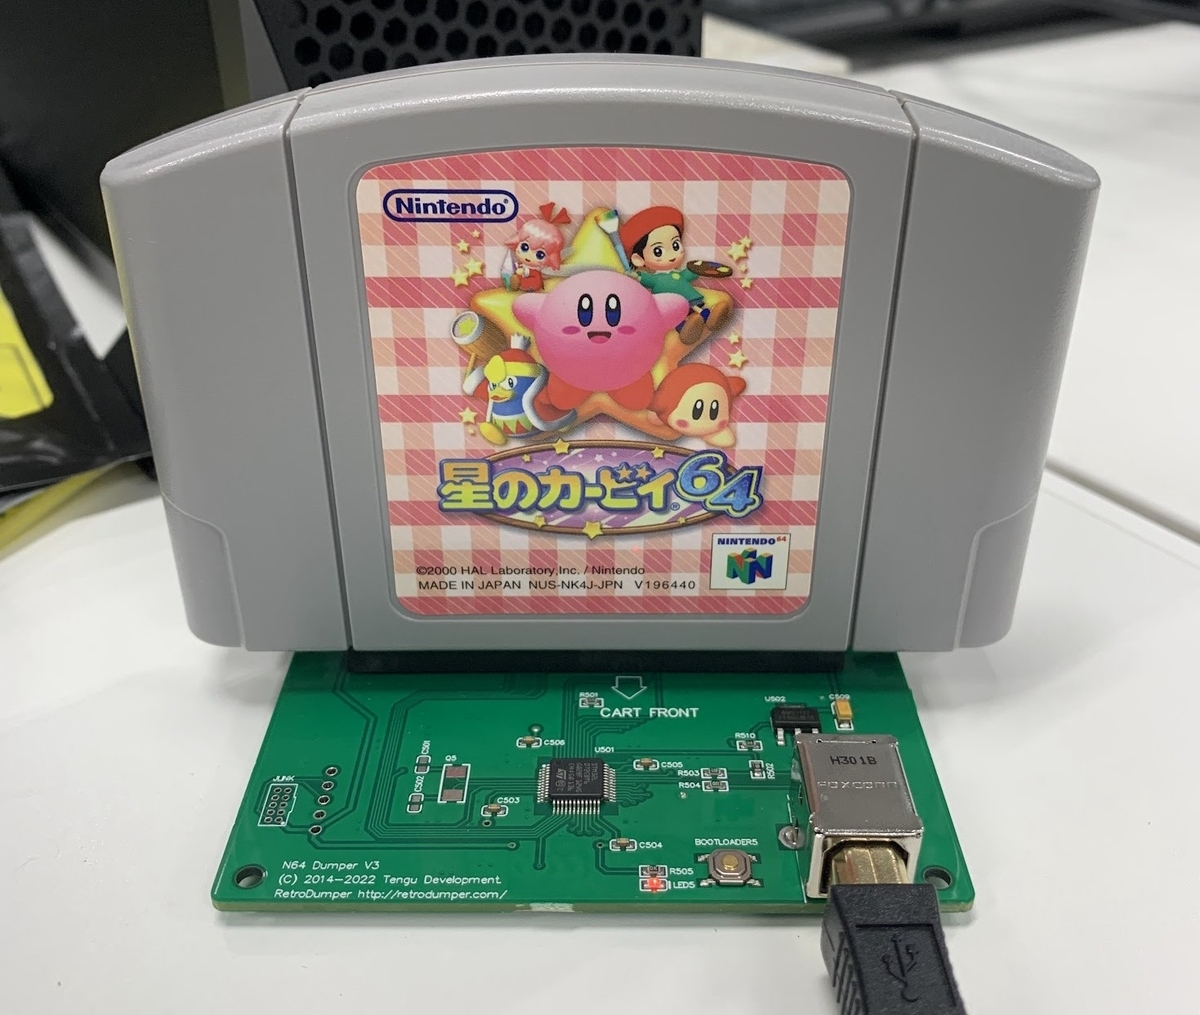
抽出の様子

2. Nintendo 64 のアーキテクチャ

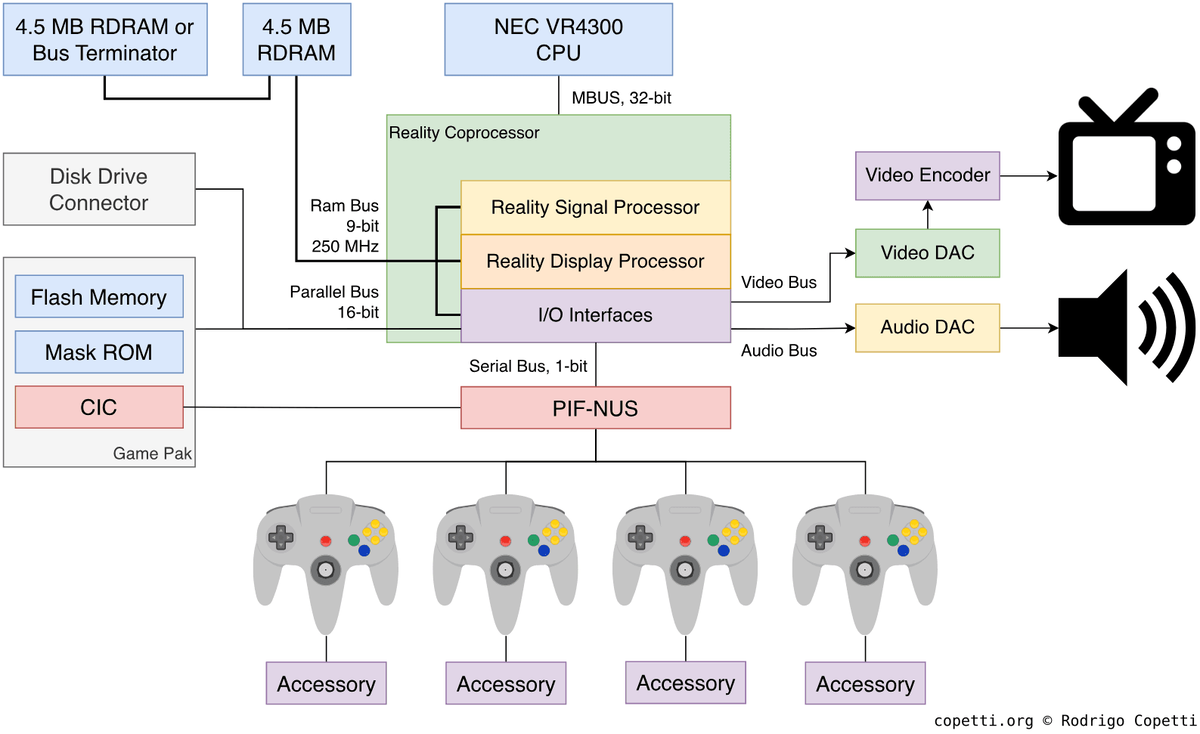
N64のアーキテクチャ

図は Rodrigo Copetti, Nintendo 64 Architecture より引用。

Nintendo 64 は大きく分けて次のコンポーネントが動作しています。

  • メイン CPU: NEC VR4300(MIPS R4300i)、93.75 MHz、FPUあり
  • RCP(Reality Co-Processor): コプロセッサ、62.5 MHz
  • RDRAM: 共有メモリ。CPU や RCP はこれを経由してデータをやり取りする
  • カートリッジ / PIF など周辺

Nintendo64のメイン CPU には SIMD 命令がなく、また現代の GPU のアーキテクチャが確立されていませんでした。 そのため、グラフィックス処理に必要なベクトル演算は専用の RSP というコプロセッサで行いました。

CPU と RCP のクロックは同じではなく(93.75Mhz : 62.5Mhz = 3:2)。エミュレータではこのクロックの比を意識して時間を進める必要があります。

CPU からの MMIO 書き込みをきっかけに、各ユニットが動き、協調動作を実現しています。

2.1 RCP の中身

RCP の中はざっくり次のような役割分担です。

名前 役割
RSP(Reality Signal Processor) スカラー+ベクトルユニット。ジオメトリや音声処理などに使われる。
RDP(Reality Display Processor) ラスタライズ、テクスチャ、ブレンディング、Z バッファなどグラフィックパイプラインの後半で使われる。
VI(Video Interface) フレームバッファをテレビ信号に変換する。エミュレーションではテレビではなく、ホストの画面に表示すれば良い。
AI(Audio Interface) 波形データを DAC 変換する。これもホストで波形を再生すればよいだけ。
PI(Peripheral Interface) カートリッジ ROM などとの DMA に使われる。
SI(Serial Interface) コントローラ/PIF 方面
MI(MIPS Interface) 割り込みの集約など

RSP はメイン CPU より遅いクロック側(RCP 全体が 62.5 MHz)で動きます。FPU は無く、ベクトル命令で 8 要素ぶんまとめて計算する、といった性格です。ゲームは Display List / Audio List を RAM に置き、RSP にマイクロコードとタスクを投げて動かします。

1 フレームのイメージはこうです。

  1. CPU がゲームロジックを回す
  2. RSP にジオメトリ等のタスクを投げる
  3. RDP が描画コマンドを処理し、フレームバッファを更新する
  4. VI が走査に合わせて画面を出す
  5. AI / SI が音声・入力を並行して扱う

エミュレータは、この協調動作ごと再現する必要があります。

3. エミュレータの実装

3.1 スケジューリング

エミュレータをどう駆動するかは最も難しく、重要な設計ポイントだと思います。

Kamo64 では、時間の基準を CPU サイクルにしています。おおよそ、画面の走査線を進めるたびにその分だけ CPU を走らせるようになっています。

前述のCPU と RCP の周波数比 3:2 ですが、毎回2つのクロックを交互に刻む方法は単純ですが遅いので、少し工夫をしています。RSP が消費したサイクルを 3/2 することで、CPU 時間に換算して、スケジューラのイベントとして待ち合わせることで、RSP と CPUのタイミングを同期しています。

周辺機器はCPUサイクルを基準としたイベントキューで動かしています。たとえば AI にオーディオの再生開始コマンドを書いた場合、それが何サイクル後に完了するという予定をタスクとしてイベントキューに入れておきます。あとで CPU が進んでその時刻になると、対応する割り込みなどを起こします。

3.2 CPU

メイン CPU は MIPS R4300i で MIPS 系の命令セットを利用します。おそらく、もっとも特徴的な点は Delay slot だと思います。(私はパタヘネでしか知りませんでした。)

Delay slot は分岐の直後の 1 命令は、分岐の成否に関係なく(branch-likely を除き)実行されるというものです。

ほかには、仮想アドレスと物理アドレスの変換を行う MMU や TLB がありますが、変換のキャッシュに使われる TLB すらエミュレーションするのにやや時間がかかるので、ホスト側でホットパスとしてキャッシュを持つことで速くしています。

3.3 RSP

RSP はメイン CPU とは別の CPU で、独自のベクトル拡張命令を実装しています。この命令セットは有志によって明らかになっています。

ベクトルユニットには、32本の128bitのレジスタがあり、各レジスタを8つの16bit値としてまとめて計算することができます。 Kamo64 では、一部の命令を Intel SSE でホストの SIMD 命令として実行することで高速化しています。

3.4 RDP

ラスタライズなどを行う RDP は、N64 界隈では Parallel-RDP という RDP エミュレーション専用のライブラリ がよく使われます。Vulkan による GPU レンダリングやアップスケーリングなどが実装されており、Kamo64 でも Parallel-RDP を採用しました。

Parallel-RDP を使わずに、いつかはレンダリングも自前で実装してみたいなと思っています。

3.5 ブートプロセス

実機のブートシーケンスは以下の流れで行われます。

  1. PIF-NUS がカートリッジの CIC を検証する
  2. CPU が PIF 内 ROM(IPL1)から実行を始める
  3. IPL2 → IPL3 と続き、RDRAM やキャッシュを初期化し、ゲームコードへ飛ぶ

CIC とはカートリッジに入っている海賊版対策用のチップで、6102、6102などのいくつかの型番が存在します。 CIC は PIF-NUS というゲーム機本体のチップによって検証され、その後の IPL の実行コードはゲーム機本体(PIF-ROM)が持っています。

ブートプロセスをエミュレーションでは、これらのステップを厳密に行わない、すなわち、CIC 種別を ROM の先頭付近のチェックサムから推定し、IPL3 実行後のレジスタやメモリの状態をでっち上げることで実現しています(HLE に近い)。

ブーロプロセスはこれらの記事がより詳しいです。

3.6 OS

N64 には本体に載った大きな BIOS や OS はありません。代わりに、カートリッジ側の ROM に、小さなカーネル相当のコードが入っています(ライブラリ OS の概念に近いと言えます)。これらのカーネル相当のライブラリには、マルチスレッドやメッセージ、スケジューリングの薄い抽象レイヤが入っています。

したがって、LLE では、BIOS や OS のエミュレーションは必要ありませんが、RSP 周りのレジスタやメモリから、音声やグラフィックスのタスクに対応するデータ(OSTaskと呼ばれる)を観察することができます。

3.7 コントローラ

実機では、入力はだいたい次の流れです。

  1. コントローラのボタン/スティック状態を読む
  2. ゲームが SI 経由で、RDRAM と PIF RAM のあいだでコマンド/応答を転送する
  3. PIF がそのコマンドを解釈し、接続確認やボタン/スティックの値を応答として返す

エミュレータでは、1 をホスト側のキーボードやゲームパッド入力に置き換え、64コン相当の状態として保持します。ゲームが問い合わせてきたときに PIF がその状態を応答に載せるので、2・3 のプロトコルはそのまま再現すればよいです。ここでは PIF も、命令レベルでエミュレーションせずに、PIF 専用コマンドを HLE でエミュレーションしています。

3.8 高速化

多くの N64 ソフトは実質 30 fps 前後で、映像出力はインターレース(奇数/偶数線を約 16.7 ms ごとに更新する方式)で動作します。したがって、エミュレーションの高速化はこの 16.67ms の枠に対して間に合うためのボトルネックを潰す作業になります。

当初はメイン CPU の JIT を頑張って実装していました。ところが、

  • cached interpreter を速くする
  • RSP の SIMD

あたりを詰めると、JIT が無くても処理落ちせずに動作できそうなことが判明しました。

cached interpreter はインタプリタ実行において、命令を毎回デコードし直さず、デコード結果をキャッシュしておく方式です。各機械語を実行する関数のポインタとして用意しておいて、その関数ポインタの配列としてページごとにデコード結果をキャッシュすればよいです。

JIT は依然として有用ですが、開発や保守のコストを考えると、インタプリタに絞るのが良いと思います。もしかしたら、GBA、DS、3DS のエミュレータでも同様のことが言えるかもしれません。

4. おわりに

エミュレータ開発は大変ですがとても楽しいです。 近年は AI も実装やデバッグにかなり使えるようになってきていて、以前より苦しさは減ってきていると思います。

Kamo64 はコントリビューションも大歓迎です!

github.com

謝辞

開発に協力してくれた以下の方々ありがとうございました。
ICFP/OOPSLA@Singapore に参加した

1. 概要

  • 会議名: ICFP, OOPSLA, MPLR
  • 期間: 2025/10/12〜2025/10/18
  • 場所: National University of Singapore(10/12), Marina Bay Sands(10/13〜10/18)

2. 自分の発表

Bringing Together Cross-ISA Checkpoint/Restoration and AOT Compilation of WebAssembly Programs (MPLR 2025)

Q&A

    1. マイグレーションポイントを減らすことができるか?
    2. マイグレーションポイントを減らすことは、即応性の低下につながるためトレードオフがある。
    3. このトレードオフを具体的に調査する必要があるが、現状ではもっと減らしても即応性への影響は少ないと思う。
    1. 移行元と移行先のケイパビリティの違いはどうするか
    2. ケイパビリティとはファイルシステムなど環境サポートの違い。
    3. Wasmではプログラムごとにcapabilityを定義するため、移行元と移行先の違いを気にする必要はない。
    4. 現在はWasmのコアスペックのみをサポートしており、ファイルやソケットの扱いは今後の課題。

今後の方向性について

マイグレーションポイントを減らす研究の方向性は面白そうに思った。GCセーフポイントを減らすことにも繋がりインパクトが大きいと思う。しかし、[人物名は削除]曰く、GCセーフポイントを減らす研究はこれ以上は難しいかもとのこと。

3. 参加したイベント・発表

WebAssembly Research Tools Tutorial (Tutorials)

内容:
WebAssembly向け研究ツールの講義。Spec Tecやwasm-fuzzer、wasm-optといった研究用ツールを紹介。Wasm向けのResearch VMの一つであるWizard VMをベースにした研究VMの特徴(in-place interpreter、singlepass baseline compiler、dynamic analysisによるinstrumentationの高速化)を解説。その後Wasm向けのinstrumentationツールであるWhammの紹介があった。WhammはDSLコンパイラであり、instrumentationコードをDSLで書くことができる。バックエンドとしてWizard用のWasmバイナリまたはWasmバイナリ書き換えをサポートしている。

感想:
Wizard VMの柔軟なinstrumentation設計と性能の両立に強い魅力を感じ、実装力次第でさらに改善と研究の余地があると思った。自分の研究でも利用したいと思う。一方でWhammのDSL部分は学術的な新規性が薄く、価値が見えにくかった。

Compiling Quantum Circuits (Tutorials)

内容:
量子回路コンパイルの概要。量子ビットとゲート(Hadamard, CNOTなど)の基礎から、NISQとFTQCの違い、ソフトウェアスタック(高レベル回路からネイティブゲートへの最適化)の説明があった。最適化ではTゲート削減が重要で、PLDI’23の回路の等価性検証を自動化する研究が紹介された。この研究では代数的手法を用いて回路の最適化の入出力ペアであるrewriting ruleを生成する。回路再合成やrewriting ruleと異なり、近似的に等価性を検査する。両者は最適化にかかる時間と回路の意味論の正確性の点でトレードオフがあるとされている。

感想:
量子計算のソフトウェア的視点を体系的に理解できた。代数式による等価性検証がゼロ知識証明と類似している点が面白いと感じた。量子分野は物理の深い理解がなくとも、数学を用いて研究できる点が魅力的だと感じた。

A guided tour through Oxidized OCaml (Tutorials)

内容:
OCamlを拡張し、メモリ安全性とデータ競合のない並行実行を保証するOxCamlの紹介。変数宣言時のlocalモードや式評価時のstack/exclaveモードなどでスコープと割当先を静的に制御することができる。Modalityでlocalityやuniqueness、portability、contentionといった性質を型より深いレベルで表現し、安全な並行プログラミングを実現することができる。

感想:
構文や参照仕様の説明が少なく初学者には難しいが、Modeを型システムに統合する発想が興味深い。RustのようなTraitによるアプローチではなく、型理論的にMutabilityを扱う点がより本質的なアプローチに感じた。特にuniqueモードはalias解析などへすぐに応用でき実用的だと感じた。

Functional Programming for Hardware Design (ICFP, Keynote)

内容:
Groqの研究者によるキーノート。関数型言語をハードウェア設計に適用し、SystemVerilogなど従来言語の曖昧な意味論を再設計する試みが紹介された。特にalwaysブロックの同時変化問題などを例に、検証容易なDSL(μFP, Rubyなど)が紹介された。

感想:
FP的抽象化をハードウェア設計に導入する流れが興味深い。既存HDLの仕様的曖昧さを改善するアプローチとして意義が大きい。

Environment-Sharing Analysis and Caller-Provided Environments for Higher-Order Languages (ICFP)

内容:
クロージャ環境を最適化するためのenvironment-sharing解析という新たな静的解析の提案。callerとクロージャ間で共有される自由変数のみをλ-liftingし、不要なヒープアロケーションを削減。高階関数対応のためエスケープ解析を組み合わせる。

感想:
部分的にλ-liftingを行うというアプローチが面白いと思った。高階関数の環境共有の有無をエスケープ解析に近い静的解析で解くことができる。

Multiple Resumptions and Local Mutable State, Directly (ICFP, Distinguished Paper)

内容:
multi-shot継続を効率的に実装する手法の提案。参照カウントに基づいてスタックコピーの要否を判定し、不要な複製を削減。Effekt言語とLLVMを用いた実装で性能評価を実施。いくつかのマイクロベンチマークで30%近く性能向上していた。

感想:
multi-shot継続での無駄なスタックコピーを避ける点が単純明快で良いと思った。仕組み自体はRustのredundant cloneと近いのか気になった。

OCaml Blockly (ICFP, JFP)

内容:
OCaml版Blocklyの発表。型・構文エラーを完全に防ぎ、教育用途に適したビジュアルプログラミング環境を提供する。スコープ付きボトムアップ構成や学生アンケートによる有効性も報告されていた。

感想:
教育現場での実践が印象的だった。初学者がOCamlに触れる入口として有効で、自分も当時あれば使いたかったと思った。

Call-Guarded Abstract Definitional Interpreters (ICFP, Distinguished Paper)

内容:
抽象解釈を動的に切り替えるCGADI手法の提案。再帰呼び出しやサイズ変化を監視して抽象化のタイミングを制御する。k-CFAより柔軟で、停止性保証の範囲では高精度な具体実行を維持することができる。

感想:
k-CFAの発展形としてより汎用的になっている点が面白い。size-change terminationについて知らなかったが、再帰的な型定義でも同様のチェックを行っているはずで理解が深まった。LLVMに実装されて欲しいと思った。

Relating Distances and Abstractions: An Abstract Interpretation Perspective (SAS)

内容:
多段階プログラミング(コードを生成するメタプログラミング)を理論的に整理した研究。引用()と展開($(e))を型システムで安全に扱う体系に加え、コード片の依存関係を型で追跡できるようにしている。let-splice構文を導入して評価順序を明確にし、型システムの保存・進行の性質を形式的に証明している。

感想:
メタプログラミングを理論的に扱えることは知らなかった。Rustのマクロもこの体系に着想を得ていることがわかった。proc macroやquote!構文の背景理解に役立った。

ScaIR: Type-safe Compiler Framework Compatible with MLIR (SCALA)

内容:
Scala向けの型安全なコンパイラインフラScaIRを紹介。MLIRをバックエンドとして利用し、従来のMLIR方言定義で必要だったTableGenの表現力の低さに起因するC++コードの型制約チェックの実装を削減できる。Scalaの型システムを活かして豊富な表現力と型安全性をもつDSLとして方言を定義できる。

感想:
実装寄りの発表という印象が強い。TableGenの制約や学習コストを減らしつつ、MLIRエコシステムを活用する点で実用的だと思う。

参考: (URLは原文のまま) - https://2025.workshop.scala-lang.org/details/scala-2025/7/ScaIR-Type-safe-Compiler-Framework-Compatible-with-MLIR

Abstracting Concolic Execution for Soft Contract Verification (SAS)

内容:
Soft Contract Verification(SCV)は契約(事前条件・不変量など)を可能な限り静的に検証し、難しい場合のみランタイム検査に回す手法。本研究はconcolic実行を抽象化し、コンパイル時にコントラクトの充足性をより多く証明できるようにした。分岐ごとの状態を分離して保持し、path-sensitiveな解析を実現する。

感想:
静的解析と動的実行の中間に位置するような手法で興味深かった。解析停止性や精度のトレードオフの理解が難しかった。

JASMaint: Portable Multi-language Taint Analysis for the Web (MPLR)

内容:
JavaScriptとWebAssemblyが連携するWebアプリケーションを対象とした多言語Taint分析フレームワーク。JS側はラッパオブジェクトでTaint伝播を実装し、Wasm側は「WaShadow」ランタイムを拡張してShadow Valueで各バイトのTaint状態を追跡。評価では既存ツールと比較し正確性を改善したが、Wasm側の計装で実行速度が200〜1200倍低下する課題が残った。

感想:
技術的新規性は限定的だが、JSとWasmの相互運用を重視している点は実用的。

Joy of Meta-Tracing Just-in-Time Compilation: More Than Just a VM Generator (MPLR, Keynote)

内容:
Meta-tracing JITの原理を部分評価と第一二村射影の観点から再考。インタプリタの実行経路をトレースし、その結果からJITコンパイラを自動生成する。RPythonによるPyPy実装の例、@dont_look_insideによるthreaded code、method compilationとの違い、multi-tier JIT構成のSmalltalkサブセット実装と評価を説明。

感想:
第一二村射影に対応づけて説明する発想が面白い。理論的理解を深めたいと思った。

Copy-and-Patch Just-in-Time Compiler for R (VMIL)

内容:
GNU RにCopy-and-Patch方式のJITを統合。機械コードテンプレート(ステンシル)をコピーし、実行時に型情報などを埋め込む。相対ジャンプを4バイトに収めるためmmapで近傍配置する工夫もある。評価では平均1.26倍高速化。

感想:
型ごとのテンプレート生成で難しさを解決している。性能改善が小さく、手法自体の再考が必要に感じた。

ASTro: An AST-based Reusable Optimization Framework (VMIL)

内容:
AST評価定義から効率的ランタイムを自動生成する最適化フレームワーク。各ノード評価をC関数で記述し、ASTフィールドを引数指定することで挙動を直接表現。ASTレベルで定義と生成を一貫して扱える。C&P方式に近く、部分特殊化・インライン化をCコンパイラ最適化に委ねる。

感想:
Graal Truffleと共通点がある。ASTからC生成でも良いのではと思ったが、C++の型・定数ジェネリクスの部分評価活用は面白そう。

Keynote and SpecTec demo (WAW)

内容:
Wasmの形式的意味論をDSLで記述し、仕様書・形式検証用コード・実装向け定義を自動生成できるSpecTecを紹介。Wasm 3.0のように命令数が多く型システムが複雑でも一貫性を保って開発できる。

感想:
形式仕様・自然言語仕様・リファレンス実装をsingle source of truthとして扱える点が良い。将来的にJITや静的検証の自動生成にも拡張できそう。

The Simple Essence of Monomorphization (OOPSLA)

内容:
モノモルフィゼーションを理論的に整理。型パラメータ間依存を「type-flow」グラフとして表現し、有限な型集合で展開可能かを静的判定する。型コンストラクタを含む閉路を持つ場合は型集合が無限となり不可能。

感想:
有限展開可能性を明確化した点が面白い。型システム設計や最適化パス選択にも利用できそう。

JavART: a Lightweight Rule-Based JIT Compiler Using Translation Rules Extracted from a Learning Approach (OOPSLA)

内容:
既存最適化JITを教師として、バイトコード列と最適化済み機械語の対応から変換ルールを学習・抽出し、ルールベースJITとして再利用する。生成ルールの意味的正しさは形式検証で保証。

感想:
過去のバイナリ変換研究に近く新規性は薄い印象。ただし既存JIT再利用の軽量方向性として堅実。

Tracing Just-in-time Compilation for Effects and Handlers (OOPSLA)

内容:
エフェクトハンドラを備えた関数型言語にMeta-tracing JITを適用。実行時トレースからperform/resumeのパターンを観測し、インライン展開やキャッシュなどを動的適用する。

感想:
静的解析最適化の限界を実行時最適化で補う発想が理にかなっている。応用範囲が広そう。

Efficient Concolic Execution of WebAssembly by Compilation and Snapshot Reuse (WAW)

内容:
Wasmを直接C++へコンパイルしてインタプリタ実行オーバーヘッドを排除し、分岐時の状態をスナップショット保存して制約反転後に再利用することで探索コストを削減。staged concolic実行も提案。

感想:
実装上の無駄を省いた設計が良い。effect handlerによるスナップショット制御など応用も考えられる。

Two Approaches to Fast Bytecode Frontend for Static Analysis (OOPSLA)

内容:
Java静的解析フレームワークでの3AC変換フロントエンドのボトルネックを解消する「Pattern-aware 3AC translation」を提案。オペランド依存をstack def-use(ブロック内で単一パス)とlocal def-use(ブロック跨ぎでSSA変換)に分け、不要な反復解析コストを削減。

感想:
既存ツールの実課題から着想している点が良い。WasmのようなスタックVMにも応用できそう。

4. 感想

会議

POPLより参加者が多いように感じた。ワークショップやカンファレンスの発表件数が多く、OOPSLAは200件ほど論文があるようで非常に充実していた。実際に広く利用されているシステムの開発者(WebAssembly Spec, Cranelift, Servo, CPython, Linux Kernel, OCaml)による発表もあり貴重な経験になった。

OOPSLAは実装するだけや調査するだけの論文が多く、現実の問題に取り組むことの重要性を反映しているのだと思った。一方で理論に取り組む研究も多く、理論的枠組みを現実システムに適用する研究が難しく面白いと思った。解決したい問題から始めて解決策を一般化していくアプローチが重要だと感じた。また、普段からさまざまなツールを使って問題点を探すことも大切だと思った。

シンガポール

暑かったが8月の京都ほどではなかった。Song FaというBak kut teh料理店がとてもおいしくて複数回行った。合間を縫って少し観光に行くことができた。特にBird Paradiseという動物園がとてもよかった。

5. 写真

夜のシンガポール湾

夜のシンガポール湾2

発表の様子

発表の様子2

会議飯

2025年振り返り

1月

アメリカ (コロラド州デンバー)で開催されたPOPLに参加した。初アメリカかつ国際会議で楽しかった。 五十嵐研の人と移動や食事を一緒にさせてもらうことが多くて非常に助かった。

バイソンの肉

2月

POPLのSRCで発表した内容についてIntelでWebAssemblyに従事している人から連絡が来て話す機会があった。 あとから調べてすごい人だと知った。

学部の卒論の諮問会があった。

Woven by Toyotaのオフィス(東京)でC++ Meetupに参加した。

3月

愛知県でプログラミング言語研究会 (PPL) に参加した。国内でプログラミング言語の研究をしている人たちとネットワーキングができて良かった。

春休みは帰省したりバイト先に遊びに行ったりしてまったりしていた。 未踏ITに応募しようとしていたので、提案書を書いていた。

4月

大学院に入学した。研究室を変えたので、人も変わった。 偶然にも前の研究室のお世話になっていた指導教員もちょうど同じ研究室に移ることになりラッキーだった。

京都 高瀬川の桜

5月

神戸に遊びに行った。 国際会議に出す論文を書いたり、実装を修正したりしていた。

6月

東京でAsia LLVM Developers' Meetingに参加した。一応LTで発表した。 会場はウェスティン東京で、LLVM Foundationから旅費を支援してもらった。 会場のホテルで2泊することができてとても良かった。(一泊8万円ほどするらしい...)

Switch2を買った!

マリオカートセット

7月

大阪万博に行った。日本にいながら海外の文化を体験したり学べたのは良かった。

祇園祭りを初めてちゃんと回った。 山鉾の建築から巡行まで見ることができた。四条通から間近で見る山鉾は大迫力だった。 縄がらみの軋む音がとても良い。

8月

8月から10月はインターンをしていた。環境(場所、時間、英語、人)に適応するのがとても大変で毎日ゲームする気力が起きないほど疲れていた。 特に一緒に働いていたアメリカ人との会話についていくのが本当に大変だったが、とても刺激的だった。

あとニンテンドーミュージアムに行った。

9月

働いていた。映画館でヒックとドラゴンを見た。舐めてたけど普通に感動した。

藝大の学祭に行った。めちゃくちゃ良かった。

新聞紙でできた人

10月

10月末にインターンが終わった。 Maker Faire Tokyoに行った。自作ロボがたくさん展示されていて色々体験できたので良かった。 シンガポールでOOPSLAに参加した。会場は1日目はNUSで2~8日目がMarina Bay Sansだった。

POPLやPPLであった多くの人も参加していた。こういう会議に毎年のように参加できるのは羨ましいなと思った。

二回目のシンガポールだったが、空いた時間でたくさん観光できた。 とくに良かったのが、Mandai Wildlifeという動物園のBird Paradiseで、デカい鳥が放し飼いされていて、頭に飛び乗ってきた!

現地で人気なSong Faというポークリブスープのレストランに行った。 このスープは世界一うまい。

ポークリブスープ

10月末には熱海観光&裾野のWoven Cityを訪問した。

さわやか

11月

就活を始めた。休んで多分の大学院の授業のキャッチアップをしていた。 システム検証とマルチエージェントシステムは大学院に入って初めて面白いと思った授業だった。

12月

名古屋でOS研究会に参加した。 以前受賞した2つの賞状を受け取った。お祝いされて気持ちよかった。

ポケモンセンター名古屋

東京で少しだけOpen Source SummitとRust Global Tokyoというイベントに参加した。 また、Google Summer of Code MeetupでGoogleの渋谷オフィスに遊びに行った。ケータリングが良すぎた。

Googleオフィス

Rustのキャラクターのフェリスくん

そして就活を終わらせた!

2026年の意気込み

2025年は教科書をじっくりと読んで勉強することが少なかったのは後悔している。 研究で成果を出せたのは良かった。

2026年でやりたいこと:

  • 腰を据えて勉強する (特にプログラム解析、コンパイラまわり)
  • 研究にも取り組みたい (2本くらい国際会議に論文を出したい)
  • 健康的な生活 (バランスの良い食事、睡眠、文化的な生活)

uvでJupyterを使う方法

1. Jupyterノートブックを含むフォルダにcdする

2. VSCodeの設定

venvのpythonを使うように .vscode/settings.jsonに以下を追加する。

{
    "python.defaultInterpreterPath": ".venv/bin/python",
}

Reload Windowで設定ファイルをロードする。

3. uvプロジェクトの初期化

uv init
uv add jupyter

4. Jupyterの起動

以下でブラウザが立ち上がる。

jupyter notebook

wasm-optのAsyncifyについて

概要

Asyncify.cpp は、WebAssembly モジュールに「一時停止・再開」機能を付与するパス(変換処理)を実装している。 これにより、C/C++ などの同期的なコードを、JS などの非同期イベント駆動環境でも「途中で止めて、後から再開」できるようにする。

1. 目的

  • WebAssembly の関数呼び出しやローカル変数の状態を保存・復元し、途中で「一時停止」や「再開」ができるようにする。
  • 例: ファイル読み込みやネットワーク待ちなど、非同期イベントで一時停止し、完了後に元の関数の続きから再開できる。

2. 主な仕組み・流れ

2.1. Asyncifyの全体像

Asyncifyは、WebAssemblyバイナリを変換し、コールスタックやローカル変数の状態を保存・復元できるようにするパスである。これにより、もともと同期的なコード(C/C++など)を、非同期イベント駆動環境(JSなど)でも「一時停止・再開」できるようにする。

AsyncifyはBinaryenのパスとして実装されており、wasm-opt --asyncify などで利用できる。変換後のWasmには、スタックの巻き戻し(unwind)・再構築(rewind)を制御するためのAPIが自動的に追加される。

2.2. 状態管理とAPI

  • __asyncify_state というグローバル変数で「今の状態(通常/アンワインド中/リワインド中)」を管理する。
    • 0: 通常実行
    • 1: アンワインド(unwinding, スタックを巻き戻して一時停止)
    • 2: リワインド(rewinding, スタックを再構築して再開)
  • __asyncify_data というグローバル変数で「保存用データ構造体」のポインタを管理する。

Asyncifyが自動生成・エクスポートする主なAPIは以下の通り:

  • asyncify_start_unwind(ptr):巻き戻しを開始する。ptrは保存用データ構造体の先頭アドレス。
  • asyncify_stop_unwind():巻き戻しを終了する。
  • asyncify_start_rewind(ptr):再構築を開始する。ptrは保存用データ構造体の先頭アドレス。
  • asyncify_stop_rewind():再構築を終了する。
  • asyncify_get_state():現在の状態を返す。

データ構造とメモリレイアウト

asyncify_start_unwindasyncify_start_rewindに渡すポインタは、Wasmのリニアメモリ上の構造体を指す必要がある。構造体のレイアウトは以下の通り:

  • オフセット0: i32(asyncify stackの開始アドレス)
  • オフセット4: i32(asyncify stackの終了アドレス)

この領域の直後に、実際のasyncify stack(状態保存用のメモリ領域)を確保する。スタックサイズが小さすぎるとunreachable例外が発生するため、十分なサイズを確保する必要がある。

2.3. コールスタックの巻き戻し・再構築

  • 一時停止したい箇所でasyncify_start_unwindを呼び出すと、Wasmランタイムはコールスタックとローカル変数の状態を保存しながら「巻き戻し」を開始する。
  • その後、asyncify_stop_unwindで巻き戻しを終了し、Wasmの実行が一時停止する。
  • 再開時はasyncify_start_rewindを呼び、保存された状態をもとに「再構築(リワインド)」を行う。
  • asyncify_stop_rewindで再構築を終了し、元の関数の続きから実行が再開される。

なぜ2回呼ぶ必要があるのか

巻き戻し・再構築の過程では、同じ関数が2回呼ばれることになる。1回目は通常実行、2回目はリワインドのため。関数内で「今が巻き戻し中か再構築中か」を判定し、適切な分岐を行う必要がある。

2.4. 例:純粋なWebAssemblyでの利用

(module
  (memory 1 1)
  (import "spectest" "print" (func $print (param i32)))
  (import "asyncify" "start_unwind" (func $asyncify_start_unwind (param i32)))
  (import "asyncify" "stop_unwind" (func $asyncify_stop_unwind))
  (import "asyncify" "start_rewind" (func $asyncify_start_rewind (param i32)))
  (import "asyncify" "stop_rewind" (func $asyncify_stop_rewind))
  (global $sleeping (mut i32) (i32.const 0))
  (start $runtime)
  (func $main
    (call $print (i32.const 1))
    (call $sleep)
    (call $print (i32.const 3))
  )
  (func $sleep
    (if
      (i32.eqz (global.get $sleeping))
      (block
        (global.set $sleeping (i32.const 1))
        (i32.store (i32.const 16) (i32.const 24))
        (i32.store (i32.const 20) (i32.const 1024))
        (call $asyncify_start_unwind (i32.const 16))
      )
      (block
        (call $asyncify_stop_rewind)
        (global.set $sleeping (i32.const 0))
      )
    )
  )
  (func $runtime
    (call $main)
    (call $asyncify_stop_unwind)
    (call $print (i32.const 2))
    (call $asyncify_start_rewind (i32.const 16))
    (call $main)
  )
)

この例では、mainを2回呼ぶことで、途中で一時停止し、外部から再開できるようになっている。

2.5. 最適化とオーバーヘッド

  • Asyncifyを有効にすると、Wasmバイナリのサイズは1.5~2倍程度になることが多い。
  • 実行速度も最大で2倍程度遅くなるが、実際に一時停止・再開を多用しない限り、オーバーヘッドは限定的。
  • importリスト(どのimportが一時停止を引き起こすか)を明示することで、不要な関数の変換を避け、サイズ・速度のオーバーヘッドを大幅に削減できる。
  • indirect call(間接呼び出し)が多い場合、静的解析が難しくなり、オーバーヘッドが増える。
  • 最適化時はwasm-opt -O1 --asyncifyのように、Asyncifyと同時に最適化パスを有効にすることが推奨される。

2.6. 注意点

  • asyncify stackのサイズが不足するとunreachable例外が発生するため、十分な領域を確保すること。
  • 最適化レベルによっては、関数のインライン展開などでAsyncifyの動作が乱れる場合がある。-O1程度が安全。
  • importリストやindirect callの扱いを適切に設定することで、オーバーヘッドを最小化できる。

(参考: Pause and Resume WebAssembly with Binaryen's Asyncify

3. 主なクラス・構造

クラス名 役割
ModuleAnalyzer どの関数が「状態を変える(アンワインド/リワインドを開始する)」可能性があるかを解析する
AsyncifyFlow 関数本体の制御フローを書き換え、「一時停止・再開」に対応できるようにする
AsyncifyLocals ローカル変数の保存・復元処理を挿入する
FakeGlobalHelper 一時的な値の保存用に「偽グローバル変数」を使う仕組みを提供する

4. 変換の例

例えば、

x = x + 1;
bar(x);
x = x / 2;

のようなコードがあった場合、

  • 「bar(x)」の呼び出しで一時停止する可能性があるなら、
  • その前後で「状態チェック」や「保存・復元処理」が自動的に挿入される。

5. オプション・カスタマイズ

  • どの関数・インポートが一時停止を引き起こすかをリストで指定できる。
  • 最適化レベルやアサート挿入、詳細なログ出力などもオプションで制御可能だ。

6. まとめ

Asyncify.cpp は、WebAssembly の関数を「途中で一時停止・再開できる」ように自動変換するパスである。

  • コールスタックやローカル変数の保存・復元
  • 状態管理用のグローバル変数APIの自動生成
  • 制御フローの書き換え
  • どの関数を変換するかの解析

などを行い、C/C++ などの「同期的なコード」を JS などの「非同期イベント駆動環境」でも自然に動かせるようにする。

POPL2025に参加した

1/21~1/27にかけてアメリカ・コロラド州デンバーで開催されたPOPL2025に参加してきました。 POPL (Principles of Programming Languages)はACM系のプログラミング言語に関するトップ会議の一つです。

本会議自体は1週間のうちの中三日あり、他の日は同じ会場で様々なワークショップが開催されていました。 私は以下のイベントに参加しました。

  • Tutorial1 (Substructural types, Parallel programming)
  • Workshop on WebAssembly
  • Workshop on theory and practice of static analysis workshop
  • Workshop on implementation of type systems
  • POPL本会議

飛行機

16時間くらい乗ってた気がします。 しんどかったです。 ヨーロッパに行った時と比べて時差ボケが本当にひどくて、アメリカに着いた後も毎日お昼寝してました。

気候

寒かったです。 夜は大体-20°Cまで冷え込みました。 寒すぎて買い物に行くたびに体の末端の感覚がなくなりました。

チュートリアル & ワークショップ

1日目の午前はsubstrural type systemの講義を聞きました。 substructural type systemは通常の型システムの基本的な3つの制約(Weakining, Exchange, Contraction)から 一部の制約を取り外すことで得られる型システムです。 例えば、通常の型システムは{E,W,C}と表され、線形型システムは{E}で、Affine型システムは{E,W}で表されます。 後半では、adjoint logicの紹介がありました。adjoint type systemではupshiftとdownshiftを導入することで、modality(型システムの制約集合)をプログラム内で変更することができます。

午後は並行プログラミングの講義でした。 最初は、workとspanによる並列計算アルゴリズムにおける実行時間の評価方法について説明があり、 後半はmplangという

2日目はWorkshop on WebAssemblyに参加しました。 数学よりの発表が多く、主にWasmの実装の安全性のmechanizationが多かったです。 他に印象に残った発表では、MLIR-to-wasmコンパイラの発表があり、LLVM IRに落とさずに抽象度が高いMLIRで最適化を行った方が、性能面で有利だという内容でした。

本会議

一週間の会議期間中に本会議のPOPLは中3日間で開催されました。

とくに印象に残っているのはいくつかありますが、まずはFluxの発表で、これはRustを篩型システムで拡張するものです。最適化や安全性に関して篩型は有用です。他には、Ocamlの並列ライブラリで数学的にデータ競合がないことを保証するという研究がありました。

量子プログラミングに関する内容も面白いものが多く、回路の意味的な等価性保ったまま最適化する研究や、Rustの線形論理を量子回路のuncomputationに利用する研究がありました。

また、昼食中にRustの意味論の設計に携わっているRalf Jungさんと写真を撮ることができました。とても嬉しかったです。

基調講演は量子コンピュータとプログラム合成に関するものがありました。

発表

自分は本会議の2日目のSRCでポスター発表に参加しました。僕はWebAssemblyコンパイラのライブマイグレーションの内容で発表しました。 英語のポスター発表は初めてでかなり緊張しました。人によっては英語の発音やスピードのせいで聞き取れないことが多くて、何度も聞き返すことがありました。もうリスニングを少し上達させたいです。

ポスター発表で上位3名に選ばれたので、翌日に口頭発表がありました。 結果は2位でした。手ぶらで帰ることにならなくて安心しました。

観光

隙間の時間でコロラド州立美術館に行ったり、レストランに行ったりしました。 次はニューヨークに行きたいです。

大学4年間で読んだ本 (コンピュータサイエンス)

はじめに

大学の4年間で読んだコンピュータサイエンスの本のリスト。 授業で使ったものは入れてない。

ソフトウェア設計

C++ソフトウェア設計 ―高品質設計の原則とデザインパターン

https://www.amazon.co.jp/dp/4814400454/

C++で大規模なソフトウェアを書く際に役に立つテクニックや考え方がまとめられている。が、内容は難しく、C++で3年以上経験がないと理解が難しいと思う。C++だけでなくSRPのような他の言語に共通する話も多い。

システムソフトウェア

Linkers & loaders

https://www.amazon.co.jp/dp/4274064379/

日本語訳されている数少ないリンカの本。静的リンク、動的リンクの基本的な仕組みは詳しく書かれている。 20年前に出版された本なので、情報が古いし、LTOなどの情報が載っていない。LLVM/gccのドキュメントやmoldの(昔のコミットの)ソースコードを読むのが良いと思う。

自作OSで学ぶマイクロカーネルの設計と実装

https://www.amazon.co.jp/dp/4798068713/

Nintendoのエミュレータ(OSがマイクロカーネル)について勉強したかったので読んだ。 マイクロカーネルの基本的な仕組みはもちろん、最近の研究でメッセージパッシングがどのように高速化されているかなどのコラムが書いてあって面白かった。

Binary Hacks Rebooted —低レイヤの世界を探検するテクニック89選

https://www.amazon.co.jp/dp/4814400853/

主にLinuxやELFに関連する箇所を読んだ。個人的にはvdsoが面白かった。

入門 eBPF ―Linuxカーネルの可視化と機能拡張

https://www.amazon.co.jp/dp/481440056X/

Linuxについて学びたくて読んだ。eBPFは日本語でまとまっている文書があまりないのでこれが良いと思う。

Compilers: Principles, Techniques, and Tools

https://www.amazon.co.jp/dp/0321486811/

コンパイラの有名な教科書。主にパーサーの章を読んだ。

並列プログラミング

詳解 Rustアトミック操作とロック ―並行処理実装のための低レイヤプログラミング

https://www.amazon.co.jp/dp/4814400519/

並列プログラミングのための全てが書かれている。メモリモデルやπ計算などのトピックも扱われていて良かった。

ハードウェア

ディジタル回路設計とコンピュータアーキテクチャ 第2版

https://www.amazon.co.jp/dp/4798147524/

アナログからアセンブリまでを解説した本。大学入学前に読んでた。 500ページくらいあってとにかく重いが、これを読めばコンピュータの基本的な仕組みを理解できると思う。

パタヘネ上・下

https://www.amazon.co.jp/dp/4296070096/

コンピュータアーキテクチャの授業ではパタヘネ上が教科書として指定された。上巻は知っている話が多かった。 前提知識がなくても読めるのは良いと思う。

RISC-VとChiselで学ぶ はじめてのCPU自作 ――オープンソース命令セットによるカスタムCPU実装への第一歩

https://www.amazon.co.jp/dp/4297123053/

RISC-VとCPU自作をやってみたかったので買った。RISC-Vのモジュール化された仕様や命令エンコーディングについて知れてよかった。

数学

型システム入門 プログラミング言語と型の理論

https://www.amazon.co.jp/dp/B07CBB69SS/

通称TAPL。ラムダ計算をベースに拡張した体型についてひたすら帰納法で証明する本。

Advanced Topics in Types and Programming Languages

https://www.amazon.co.jp/dp/0262552671/

TAPLの発展編。リージョン推論とsubstructural type systemの箇所を読んだ。 POPLに行ったときにまさか役に立つとは思わなかった。

Principles of Program Analysis

https://www.amazon.co.jp/dp/3642084745/

サークルの輪読会で読んだ。コンパイラでよく使われている解析手法の基礎について学ぶことができる。 束(lattice)、半順序、余帰納法などの数学的な概念を学ぶことができて良かった。

その他

コンピュータネットワーク第6版

https://www.amazon.co.jp/dp/4296070428/

ネットワークの教科書。研究室の輪読会で読んだ。最初は何を勉強しているのかよくわからなかったが、TCP/IPプロトコルを自作してみると繋がりが理解できるようになって良かった。

Winnyの技術

https://www.amazon.co.jp/dp/4756145485/

当時のP2Pソフトウェアの課題であった通信速度などをどのように解決したか、どのようにファイルを分散管理したか、などの技術的な話が書かれている。面白かった。

セキュリティコンテストチャレンジブック -CTFで学ぼう! 情報を守るための戦い方-

https://www.amazon.co.jp/dp/4839956480/

pwnの章を読んだ。最近はもっと新しい本が出ている。